e-means: outperforming k-means (in-one-tenth the epochs)
들어가며
얼마 전 Meta FAIR에서 e-means라는 논문을 공개했습니다. 제목부터 “k-means보다 좋은 결과를 10분의 1의 epoch로 낼 수 있다”고 하면서 많은 연구자의 눈길을 끌었습니다. 사실 결론부터 말하면 정말 처음 보는 기법을 이용한건 아닙니다. 되려 자주 봐왔던 아이디어들을 이용해서 성능을 끌려올렸습니다. mini-batch k-means에 지수이동평균(Exponential Moving Average, EMA) 업데이트를 사용하고 딥러닝에서 자주 볼 수 있는 몇 가지 기술을 추가한 뒤, hyperparameter를 실험 기반의 공식으로 정해 버린 논문에 가깝습니다. 이 논문에서 제시하는 결과는 아래와 같습니다.
- 여러 임베딩 데이터셋에서 Lloyd 알고리즘이 25 epoch에 도달하는 test 손실을 1.4~2.6 epoch 만에 넘어섬
- GPU wall-clock 기준으로 기존 구현보다 10~45배 빠름
- 100억 개의 DINO 임베딩을 약 1,670만 개 클러스터로 나누는 데 2.5 epoch면 충분함
이 글에서는 실험 결과보다 알고리즘 자체를 중심으로 정리합니다.
배경
k-means와 Lloyd 알고리즘
k-means는 데이터 $X = \lbrace x_1, \dots, x_n \rbrace \subset \mathbb{R}^d$를 $k$개의 centroid로 나눌 때 각 점과 가장 가까운 centroid 사이의 평균 제곱거리를 최소화하는 문제입니다.
\[\mathrm{MSE} = \frac{1}{n}\sum_{i=1}^{n} \lVert x_i - c_{a(i)} \rVert^2, \quad a(i) = \arg\min_{j} \lVert x_i - c_j \rVert^2\]가장 많이 쓰는 Lloyd 알고리즘은 전체 데이터를 각 centroid에 할당하고 centroid를 할당된 점들의 평균으로 바꾸는 과정을 반복합니다. 손실이 단조 감소하므로 국소 최솟값에 수렴하지만 centroid가 epoch마다 한 번밖에 움직이지 않습니다. 논문에서는 Faiss의 기본값인 25 iteration을 기준점(Lloyd@25)으로 씁니다.
참고로 논문은 벡터를 볼드체로 따로 표시하지 않습니다. 그래서 수식이 스칼라처럼 보이는데 $x$, $c_j$, 그리고 뒤에 나올 $S_j$, $s_j$는 모두 $d$차원 벡터입니다.
기존 mini-batch k-means의 한계
MacQueen(1967)과 Sculley(2010)의 mini-batch k-means는 batch마다 centroid를 업데이트해서 epoch당 여러 번 움직입니다. centroid마다 지금까지 할당된 점의 수 $v_j$를 세고 step $1/v_j$로 이동하기 때문에 centroid는 결국 그동안 할당된 모든 점의 running mean이 됩니다.
\[c_j \leftarrow c_j + \frac{1}{v_j}(x - c_j)\]빠르긴 하지만 논문에서는 아래와 같은 한계가 있다고 제시합니다.
- Lloyd보다 빨리 수렴하지만 최종 오차가 더 높음
- 새 데이터셋마다 batch 크기와 step을 감으로 정해야 함
- 점을 받지 못하게 된 centroid(dead cluster)를 대부분 방치함
EMA 업데이트
e-means는 VQ-VAE가 codebook을 학습할 때 쓰던 EMA 업데이트를 활용합니다. 클러스터마다 count $N_j$와 sum $S_j$를 두고 batch에서 클러스터 $j$에 할당된 점의 수 $n_j$와 합 $s_j$로 두 값을 업데이트합니다. 여기서 $\alpha = 1 - \gamma$는 EMA의 step입니다.
\[N_j \leftarrow \gamma N_j + \alpha\, n_j, \qquad S_j \leftarrow \gamma S_j + \alpha\, s_j, \qquad c_j = \frac{S_j}{N_j}\]Centroid는 따로 저장하지 않고 필요할 때마다 $S_j / N_j$로 계산합니다.
Centroid의 실제 의미
이해를 돕기 위해 식을 조금 더 풀어서 써보겠습니다. $t$번째 업데이트는 다음과 같습니다.
\[S^{(t)} = \gamma_t S^{(t-1)} + \alpha_t s^{(t)}\]여기서 $S^{(t-1)}$ 자리에 같은 식을 한 번 더 넣어 보겠습니다.
\[S^{(t)} = \alpha_t s^{(t)} + \gamma_t \alpha_{t-1} s^{(t-1)} + \gamma_t \gamma_{t-1} S^{(t-2)}\]이 과정을 계속 반복하면 batch마다 붙는 계수에 규칙이 보입니다.
| Batch | 계수 |
|---|---|
| $t$ (가장 최근) | $\alpha_t$ |
| $t-1$ | $\alpha_{t-1}\,\gamma_t$ |
| $t-2$ | $\alpha_{t-2}\,\gamma_{t-1}\,\gamma_t$ |
| $s$ | $\alpha_s\,\gamma_{s+1}\cdots\gamma_t$ |
Batch $s$의 합 $s^{(s)}$는 처음 들어올 때 $\alpha_s$만큼 반영됩니다. 그 뒤로는 업데이트가 한 번 일어날 때마다 $S$ 전체에 $\gamma$가 곱해지므로 이 batch의 몫에도 $\gamma$가 하나씩 더 붙습니다. $\gamma$는 1보다 작으니 오래된 batch일수록 1보다 작은 수가 더 많이 곱해져서 가중치가 기하급수적으로 줄어듭니다. $N$의 계수도 동일하므로 $c_j = S_j / N_j$는 결국 지금까지 $j$에 할당된 모든 점의 가중 평균이고, 각 점의 가중치는 해당 점이 포함된 batch의 계수입니다.
Step이 일정하면 계수가 $\alpha(1-\alpha)^{t-s}$가 되어 더 직관적으로 이해할 수 있습니다. 예를 들어 $\alpha = 0.1$이면 한 batch 전의 점은 최근 점의 0.9배, 열 batch 전의 점은 약 0.35배만 반영됩니다. 그래서 centroid는 대략 최근 $1/\alpha$개 batch에 할당된 점들의 평균이라고 볼 수 있습니다. 코사인 스케줄에서는 $\alpha$가 업데이트마다 달라서 계수가 이렇게 깔끔한 거듭제곱 꼴이 되지 않습니다. 그래도 상한은 구할 수 있습니다. $\alpha$는 floor인 $0.1\alpha_0$보다 작아지지 않으므로 $\gamma$는 학습 내내 $1 - 0.1\alpha_0$보다 커지지 않습니다. 그래서 $k$번의 업데이트 전에 들어온 batch의 가중치는 아무리 커도 $\alpha_0 (1 - 0.1\alpha_0)^k$를 넘지 못합니다. 예를 들어 $\alpha_0 = 1$이면 10번 전 batch의 가중치는 0.35 이하, 50번 전 batch의 가중치는 0.005 이하입니다.
모든 점에 같은 가중치를 주는 running mean과 비교하면 과거 할당 정보의 가중치를 줄인다는 점이 가장 큰 차이입니다.1
클러스터마다 서로 다른 이동량
업데이트 전 centroid $c_j$와 batch 평균 $\bar{x}_j = s_j / n_j$로 업데이트식을 정리하면 다음과 같습니다.
\[c_j' = c_j + \eta_j (\bar{x}_j - c_j), \qquad \eta_j = \frac{\alpha\, n_j}{\gamma N_j + \alpha\, n_j}\]$\alpha$는 모든 클러스터에 같지만 centroid가 실제로 움직이는 비율 $\eta_j$는 클러스터마다 다릅니다.
- 정상 상태에서는 $N_j \approx n_j$이므로 $\eta_j \approx \alpha$
- 한동안 점을 받지 못해 $N_j$가 줄어든 클러스터는 $\eta_j$가 커져서 새로 들어온 점 쪽으로 빠르게 이동함
- 이번 batch에서 점을 하나도 받지 못하면($n_j = 0$) centroid가 제자리에 머묾
마지막 설명이 dead cluster 문제의 원인이 됩니다. Dead cluster는 뒤에서 자세하게 다룰 예정입니다.
초기화: $N_j = 10^{-10}$
초기 centroid는 데이터에서 무작위로 $k$개를 뽑고 $N_j = 10^{-10}$, $S_j = N_j c_j^{(0)}$로 시작합니다. 처음 봤을 땐 별 의미 없는 선택처럼 보였는데 식을 넣어 보면 이유가 있습니다. 클러스터가 처음으로 점을 받는 순간을 계산해 보면 다음과 같습니다.
\[c_j = \frac{\gamma \cdot 10^{-10}\, c_j^{(0)} + \alpha\, s_j}{\gamma \cdot 10^{-10} + \alpha\, n_j} \approx \frac{s_j}{n_j}\]분자와 분모의 $\alpha$가 약분되므로 $\alpha$가 아무리 작아도 첫 batch에서 centroid가 batch 평균으로 바로 이동합니다. 초기 centroid는 첫 할당을 정하는 데만 쓰이고 최종 결과에 기여하는 부분은 매우 적어집니다. $N_j = 0$이면 비율을 계산할 수 없고 $N_j$를 1처럼 크게 잡으면 무작위 초기점 쪽으로 끌리는 편향이 오래 남습니다.2
k-means++ 초기화를 쓰면 결과가 조금 좋아지긴 합니다. 하지만 1M 규모에서 train MSE가 0.2% 미만 개선되는 데 비해 비용은 학습보다 훨씬 큽니다. DEEP 데이터셋 기준으로 k-means++ 초기화에 2,852초가 걸렸고 e-means 5 epoch 학습은 22.3초였습니다. 그래서 논문은 모든 실험에서 무작위 초기화를 씁니다.
코사인 스케줄
e-means는 step $\alpha$를 학습 동안 코사인 곡선으로 줄입니다.
\[\alpha(t) = \alpha_0\left(\varepsilon + (1-\varepsilon)\,\frac{1}{2}\left(1 + \cos\frac{\pi t}{M}\right)\right), \qquad \varepsilon = 0.1\]$t$는 업데이트 번호이고 $M$은 전체 업데이트 횟수입니다. 논문에는 decay $\gamma(t)$를 정의한 식은 따로 없습니다. Algorithm 1에 $\gamma \leftarrow \gamma(t)$라고만 쓰고 위 식을 가리키므로 $\gamma(t) = 1 - \alpha(t)$로 읽어야 합니다.
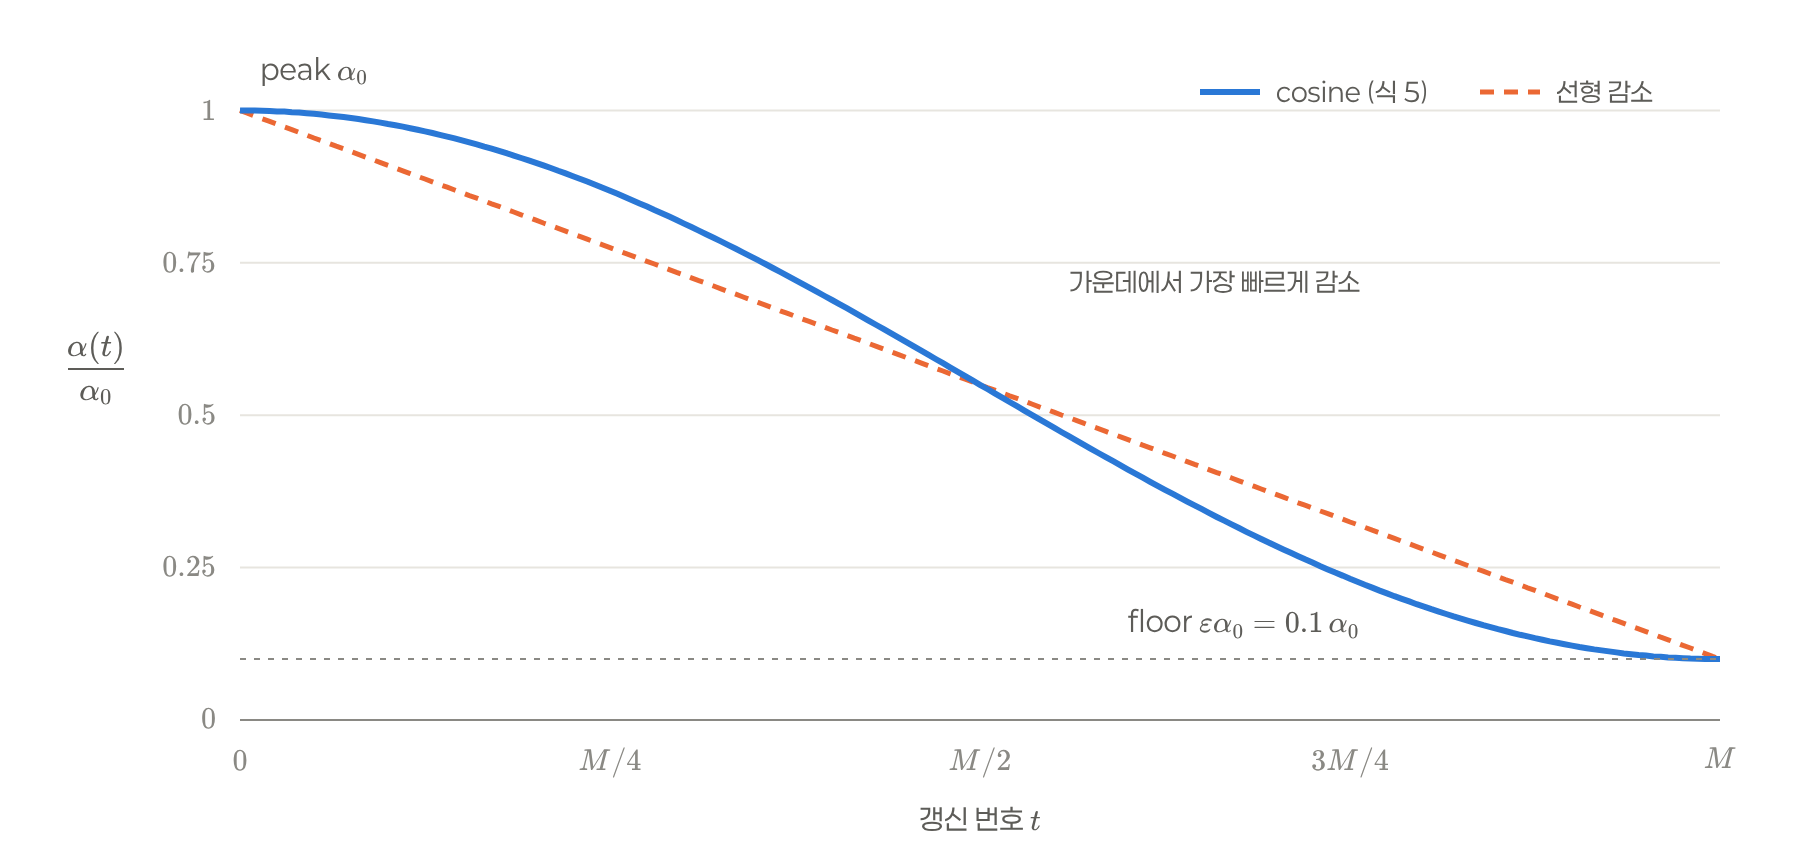 Step $\alpha(t)$가 peak $\alpha_0$에서 floor $0.1\alpha_0$까지 줄어드는 모습
몇 가지 짚고 넘어갈 내용이 있습니다.
- 주기적인 스케줄이 아님: $\pi t / M$이 0에서 $\pi$까지만 움직이므로 코사인 곡선의 반 주기만 씁니다. SGDR(Stochastic Gradient Descent with Warm Restart)처럼 재시작하지 않고 한 번 단조 감소하고 끝납니다.
- $\alpha$가 크다는 의미: $\alpha$는 $(0, 1]$ 범위의 값입니다. 크다는 말은 1에 가깝다는 뜻이고 새 batch 평균을 많이 반영해서 centroid가 크게 움직인다는 의미입니다.
- 설계 의도: 초반에는 크게 움직여 무작위 초기 위치를 빨리 벗어나고 후반에는 작게 움직여 batch마다 다른 노이즈를 평균화합니다. floor가 $0.1\alpha_0$이므로 마지막 batch까지 업데이트는 멈추지 않습니다.
효과는 train 쪽에서 분명하고 test 쪽에서는 적은 편입니다. Validation으로 다시 튜닝한 최적의 고정 step과 비교하면 train MSE는 8개 설정 모두에서 0.26~1.29% 좋아졌지만 test MSE는 −0.06~+0.54%로 설정마다 달랐습니다.
논문은 이 맥락에서 코사인 스케줄을 쓴 사례가 없다고 주장하는데 그대로 받아들이기엔 어폐가 있습니다. 감소하는 step은 MacQueen과 Sculley가 이미 썼고 EMA 계수를 코사인으로 키우는 방법은 BYOL에도 있습니다. 새로운 부분은 k-means의 EMA centroid 업데이트와 결합했다는 점이 새로운 포인트로 생각해야 합니다.
Dead cluster revival
Dead cluster가 생기는 이유
앞에서 본 것처럼 batch에서 점을 받지 못한 centroid는 움직이지 않습니다. 주변 centroid가 계속 움직이며 점을 가져가면 이 centroid는 다시 할당받을 기회를 잃고 손실을 줄이는 데 전혀 기여하지 못합니다. e-means는 5 batch마다 count가 평균의 10% 아래로 떨어진 클러스터를 dead로 판정하여 이 문제를 해결합니다.
\[N_j < \tau \cdot \frac{1}{k}\sum_{i} N_i, \qquad \tau = 0.1\]EMA count는 지수적으로 줄어들 뿐 정확히 0이 되지 않으므로 “할당 수 0”이 아니라 평균 대비 비율로 판정합니다.3
Donor 분할
Dead cluster를 무작위 점으로 다시 뽑지 않고 살아 있는 클러스터 하나를 둘로 나눠 한쪽을 넘겨주는 방식을 사용합니다. Faiss가 Lloyd에서 쓰는 방식을 mini-batch에 맞게 옮겼다고 보면 될 것 같습니다.
- Count $N_{j’}$에 비례하는 확률로 donor $j’$를 뽑음
- Donor centroid의 좌표에 $1+\delta$와 $1-\delta$를 번갈아 곱해 서로 조금 다른 두 centroid를 만듦
- Donor의 count를 반으로 나눠 두 클러스터에 $N_{j’}/2$씩 줌
- $S_j = c_j N_j$로 다시 써서 $S_j / N_j$가 새 centroid를 가리키게 함
$\delta$는 BF16의 machine epsilon인 $2^{-7}$입니다. 낮은 정밀도로 할당하더라도 두 centroid가 같은 값으로 반올림되지 않을 만큼은 커야 하기 때문입니다.
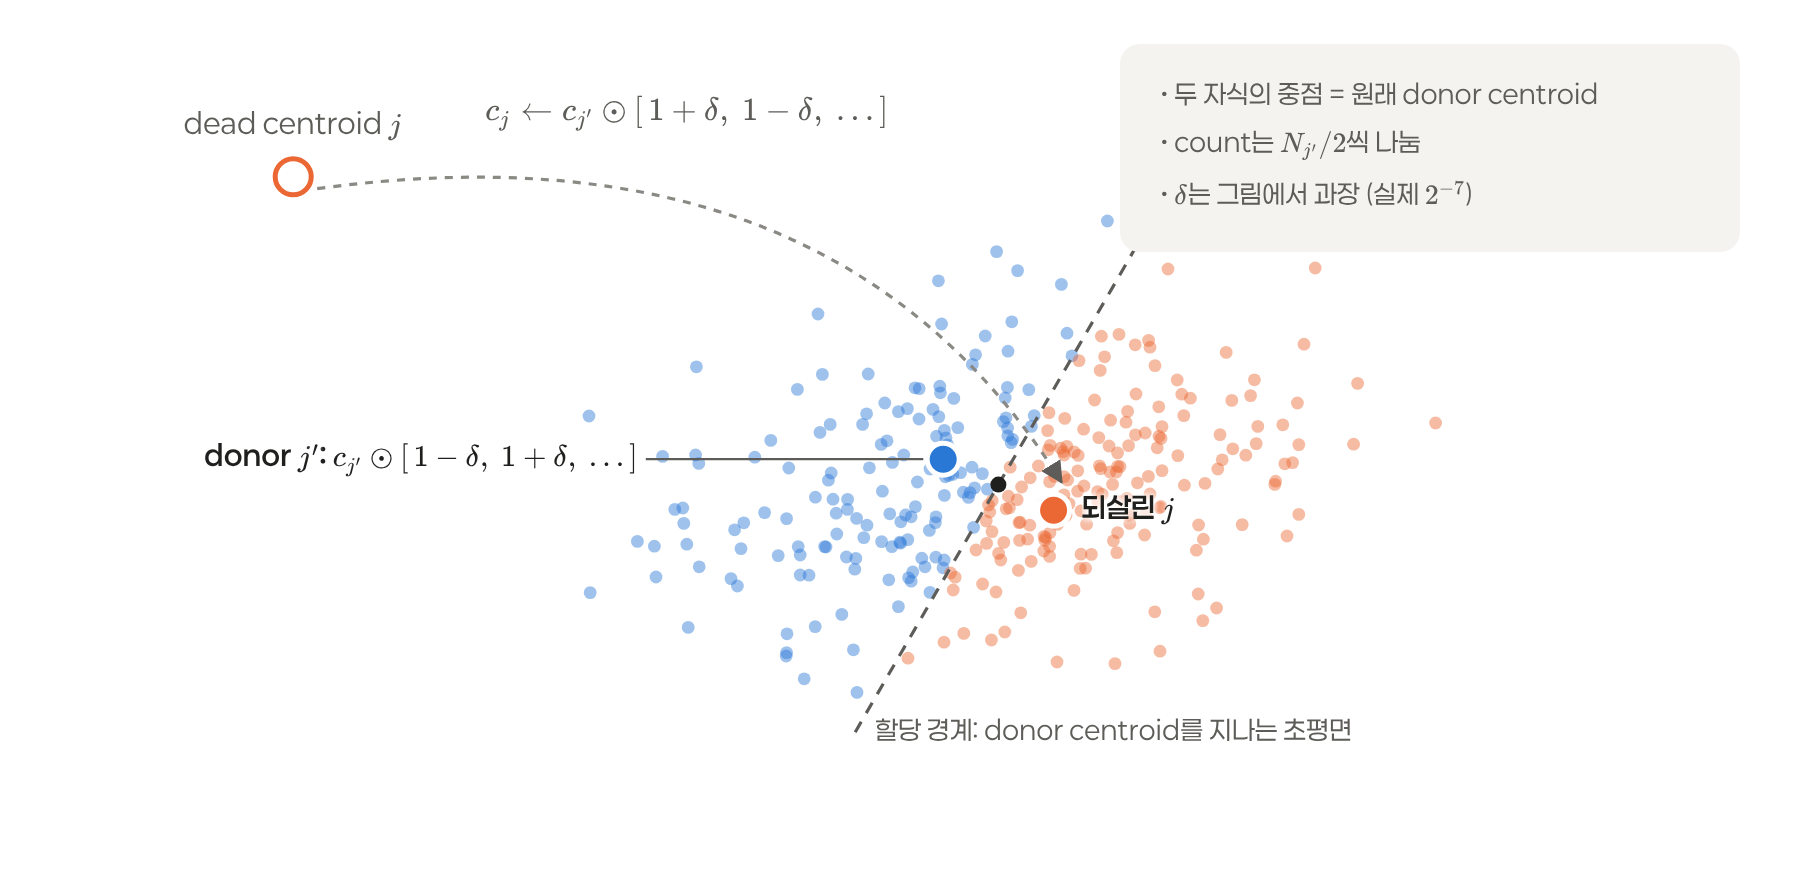 Donor 분할. 두 자식 centroid의 중점이 원래 donor centroid이므로 할당 경계가 donor centroid를 지납니다. 그림에서는 $\delta$를 과장했습니다.
두 자식 centroid의 중점이 원래 donor centroid이므로 둘 사이의 할당 경계는 donor centroid를 지나는 초평면이 됩니다. 덕분에 donor 클러스터의 점이 대략 절반씩 나뉩니다. 클러스터에 속한 점을 읽지 않고 centroid만 바꾸므로 비용도 상수입니다. 분할 직후에는 두 centroid가 거의 겹쳐 있지만 이후 EMA 업데이트을 거치면서 각자 경계 한쪽의 점을 받으며 멀어집니다. Donor를 크기에 비례해서 뽑는 이유는 논문에 나와 있지 않습니다.4
효과
Ablation에서 가장 큰 영향을 준 구성 요소가 revival입니다. DEEP 1M, $k = 16{,}384$, 3 epoch 기준으로 revival을 끄면 train MSE가 2.97% 나빠지고 VQ-VAE처럼 batch에서 무작위 벡터로 다시 뽑아도 2.06% 나빠집니다. 최종 할당에서 벡터를 10개 미만으로 받은 클러스터를 dead로 세면 차이가 더 분명합니다.
| Revival 방식 | Dead cluster 비율 |
|---|---|
| Donor 분할 (e-means) | 0.3% |
| Batch에서 재샘플링 | 14.3% |
| Revival 없음 | 26.3% |
Finalization
학습이 끝나면 최종 centroid를 두 방식 중 하나로 만듭니다. 두 방식 모두 계산 비용이 작아서 한 번 학습할 때 두 벌을 모두 만들어 둘 수도 있습니다.
last-epoch-mean
마지막 epoch 동안 모든 점의 할당을 기록해 두었다가 학습이 끝나면 각 centroid를 할당된 점들의 단순 평균으로 바꿉니다. 기본값으로 쓰는 방식이고 이미 계산한 할당을 다시 쓰므로 데이터를 한 번 더 읽을 필요가 없습니다.
할당을 고정했을 때 train MSE가 반드시 줄어든다는 사실은 아래 식으로 확인할 수 있습니다. 클러스터 $j$에 할당된 점의 집합을 $A_j$, 그 평균을 $m_j$라 하면 다음과 같습니다.
\[\sum_{x \in A_j} \lVert x - c \rVert^2 = \sum_{x \in A_j} \lVert x - m_j \rVert^2 + \lvert A_j \rvert \, \lVert m_j - c \rVert^2\]EMA centroid를 $m_j$로 바꾸면 손실이 정확히 $\lvert A_j \rvert \, \lVert m_j - c_j \rVert^2$만큼 줄어듭니다.
처음엔 마지막 epoch에서 할당이 거의 바뀌지 않을 텐데 무슨 이득이 있나 싶었습니다. 이득은 할당이 바뀌어서 생기는 게 아니라 가중치가 바뀌어서 생깁니다. EMA centroid는 최근 점에 치우친 가중 평균이라서 클러스터 평균을 일부 표본으로 추정한 값에 가깝습니다. last-epoch-mean은 모든 점을 같은 가중치로 평균 계산해 이 오차를 없앱니다.5 다만 epoch 안에서도 centroid가 움직였기 때문에 Lloyd 1 iteration과 같지는 않습니다.
Slow EMA
새로 들어올 벡터에 centroid를 적용하는 경우라면 slow EMA를 씁니다. 마지막 epoch에만 쓰는 장치가 아니라 학습 전체에서 매 batch 업데이트하는 별도의 EMA 방식입니다.
- 기존 EMA의 할당 결과를 받아 count와 sum을 누적함
- 코사인 스케줄 대신 상수 step을 씀 (코사인 floor $\varepsilon\alpha_0$의 1/16, 1/4, 1, 4배 중 validation으로 선택)
- 할당 계산에는 쓰지 않으므로 학습 경로를 바꾸지 않고 revival 분할은 그대로 따라감
논문은 slow EMA를 일종의 regularizer로 설명합니다. Train MSE를 조금 희생하는 대신 test MSE에서 이득을 보는 구조입니다. DEEP 10M, $k = 131{,}072$에서 두 방식을 비교하면 정확히 반대 방향으로 움직입니다.
| finalization | train MSE 변화 | test MSE 변화 |
|---|---|---|
| last-epoch-mean | −0.132% | +0.014% |
| Slow EMA | +0.698% | −0.082% |
클러스터당 점의 수 $n/k$가 작을수록 두 방식의 효과가 커집니다. 정리하면 centroid를 학습 데이터 자체에 쓸 땐 last-epoch-mean, 이후 들어올 새 벡터에 쓸 땐 slow EMA를 고르면 됩니다.6
전체 알고리즘
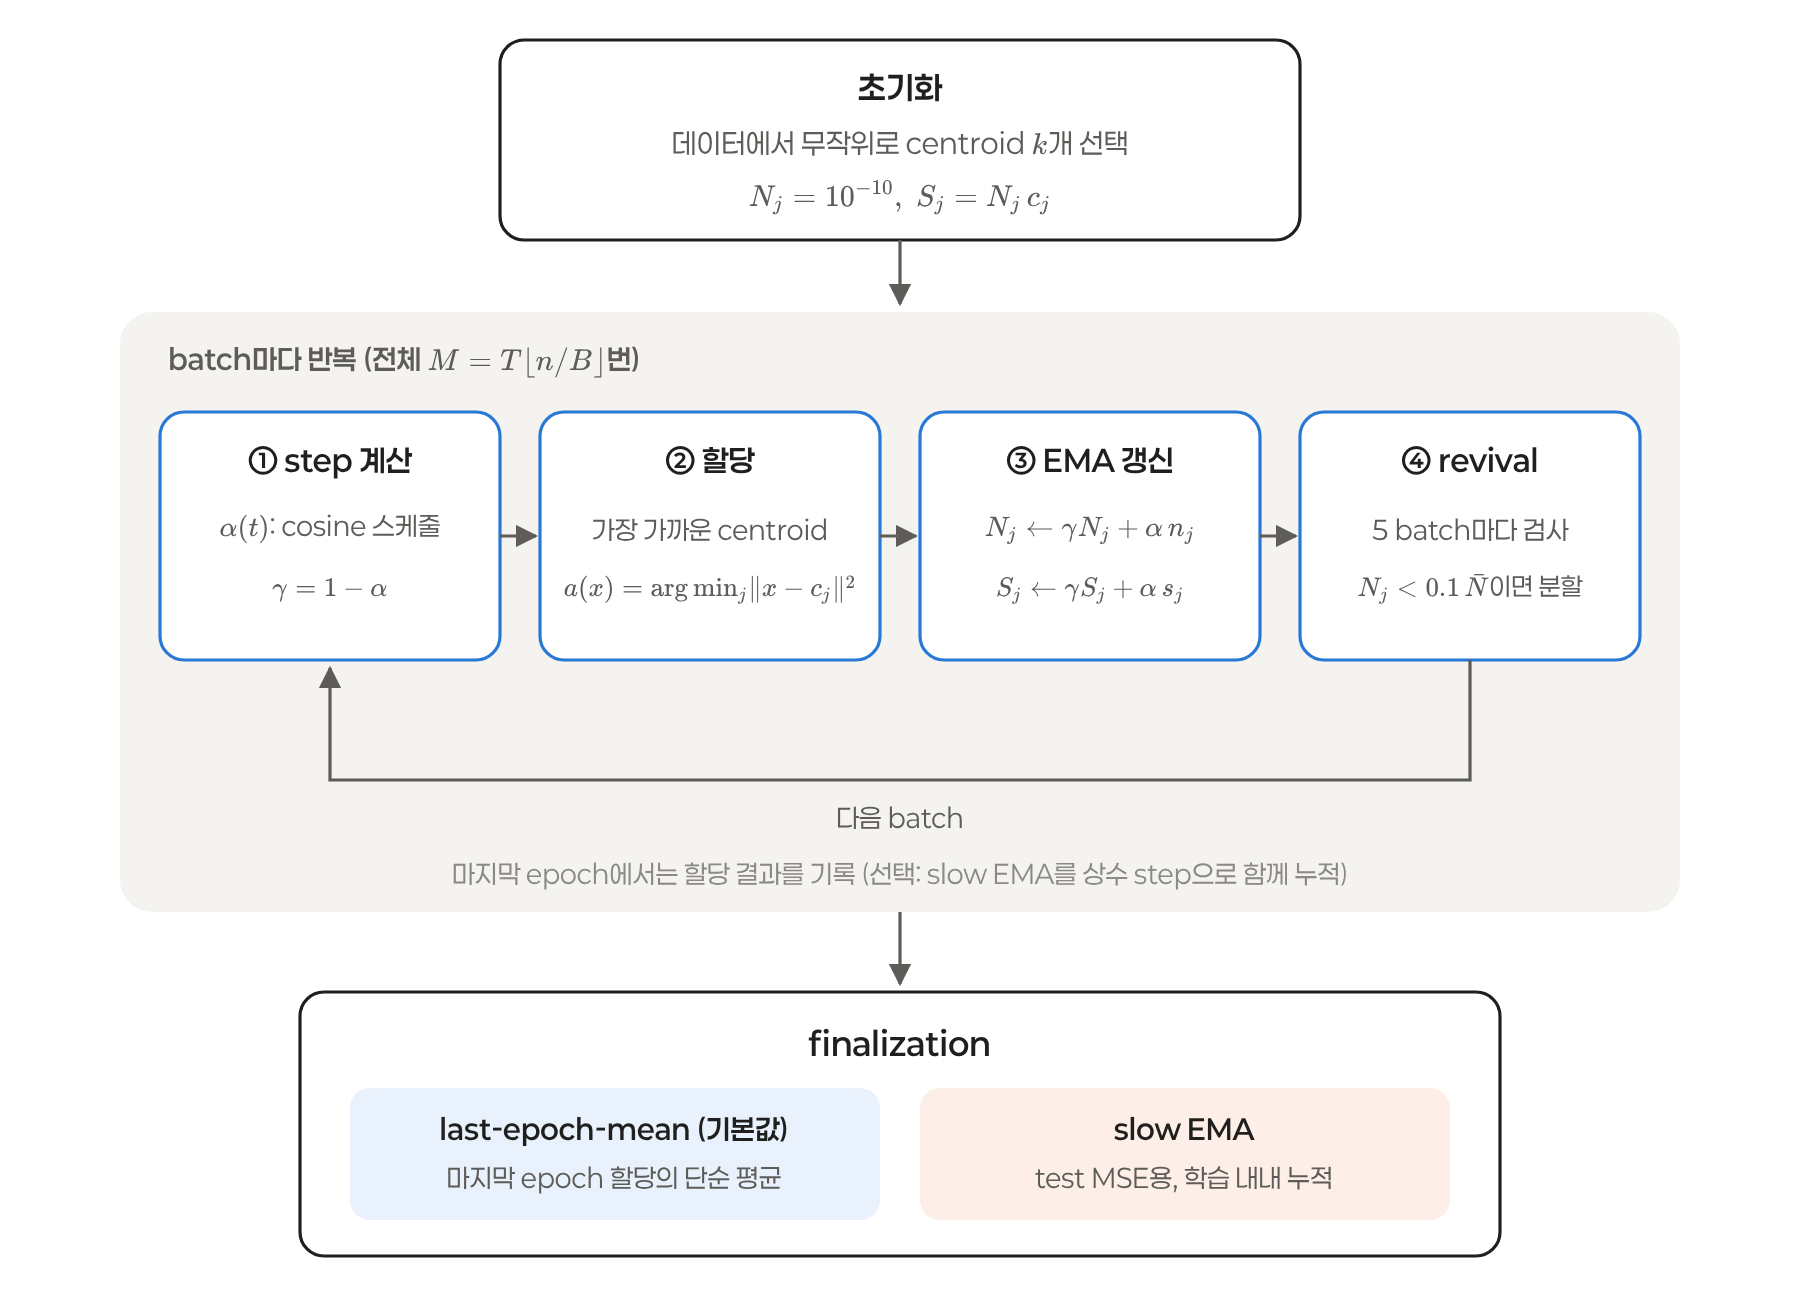
지금까지의 내용을 하나로 묶으면 아래와 같습니다.
1
2
3
4
5
6
7
8
9
10
1  c_1, ..., c_k ← X에서 무작위로 k개,  N_j ← 1e-10,  S_j ← N_j × c_j
2  for epoch = 1, ..., T:
3      for 각 batch B:
4          t ← t + 1,  α ← α(t),  γ ← 1 − α
5          a(x) ← argmin_j ‖x − S_j / N_j‖²              # 할당
6          N_j ← γ N_j + α n_j,  S_j ← γ S_j + α s_j        # EMA 업데이트
7          (선택) slow EMA도 상수 step으로 누적
8          if 마지막 epoch: 할당 기록
9          if t mod 5 == 0: N_j가 평균의 10% 미만인 j를 donor 분할로 되살림
10 c_j ← 마지막 epoch에 j로 할당된 점들의 평균          # last-epoch-mean
Epoch당 계산량은 할당 단계가 대부분이라 Lloyd와 비슷합니다. 차이는 centroid가 epoch마다 $\lfloor n/B \rfloor$번 움직인다는 점에서 나옵니다.
구성 요소별 기여
DEEP 1M, $k = 16{,}384$, $T = 3$에서 구성 요소를 하나씩 바꿨을 때의 결과입니다. 양수는 기본 레시피보다 나쁘다는 뜻입니다.
| 변경 | Train MSE | Test MSE |
|---|---|---|
| 코사인 스케줄 없음 | +0.26% | −0.06% |
| Revival 없음 | +2.97% | +2.24% |
| Revival을 재샘플링으로 | +2.06% | +1.15% |
| Finalization 없음 | +0.14% | +0.02% |
| Slow EMA로 마무리 | +0.14% | −0.08% |
| k-means++ 초기화 | −0.18% | −0.11% |
Revival만 2%대의 차이를 만들고 나머지는 모두 0.3% 미만입니다. k-means++ 초기화만 기본 레시피보다 낫지만 앞에서 본 것처럼 초기화 비용이 학습보다 훨씬 큽니다.
스케일링 법칙
개인적으로 이 논문에서 가장 실용적인 부분이면서도 실험을 통해 경험식을 도출한 내용이라 중요하면서도 그냥 받아들여야 하는지 조금 의문을 가졌던 부분입니다. 기존 mini-batch k-means의 약점으로 hyperparameter 선택을 꼽을 수 있는데, 이 문제를 실험을 통해 하나의 공식으로 정리했습니다.
두 가지 법칙
\[\alpha_0 = \min\left(0.824\, k^{-0.46} B^{0.90} n^{-0.45} T^{-0.11},\ 1\right), \qquad B = 0.035\, k^{0.13} n^{0.88} T^{0.81}\]- Decay law: 첫 번째 식입니다. $(k, n, T, B)$를 고정하고 $\alpha_0$를 바꿔 가며 validation MSE를 재면 최저점이 하나 생깁니다. 이 최저점(valley)을 맞춘 식입니다. $\alpha_0$는 속도와 무관하게 품질만 바꾸는 값이라 최저점을 타깃으로 잡았습니다.
- Batch law: Batch 크기는 넓은 범위에서 품질이 비슷하다가 어느 지점을 넘으면 급격히 나빠집니다. 그래서 MSE가 최솟값 대비 +0.2% 안에 머무는 가장 큰 batch(knee)를 맞춥니다. Batch는 속도와 품질 사이의 트레이드오프와 관련이 있어 품질을 조금만 희생하는 선에서 가장 큰 값을 타깃으로 잡았습니다. 계산 결과는 2의 거듭제곱으로 반올림하고 $n > 2\text{M}$이면 8로 나눕니다.
지수를 읽는 방법
거듭제곱 법칙의 지수는 탄력성으로 읽으면 이해하기 편합니다. 입력이 2배가 되면 출력은 $2^a$배가 됩니다.
- $B^{0.90}$: Batch를 2배로 키우면 최적 step이 약 1.87배 커짐. 영향이 가장 큼
- $k^{-0.46}$, $n^{-0.45}$: 클러스터 수나 데이터 수를 2배로 늘리면 step이 약 0.73배로 줄어듦
- $T^{-0.11}$: 영향이 미미함
결국 $\alpha_0$는 $B$에 강하게 묶여 있어서 둘을 따로 튜닝하면 안 됩니다. 딥러닝에서 batch를 키울 때 learning rate를 함께 키우는 것과 비슷한 관계입니다.7
쓰는 순서와 만든 순서
쓸 때는 batch law로 $B$를 구하고 그 값을 decay law에 넣어 $\alpha_0$를 구합니다. 그런데 이 법칙을 도출할 때는 정반대 순서였다고 합니다. 우선 decay law를 먼저 적합시키고 batch law는 batch마다 $\alpha_0$를 다시 탐색하지 않고 decay law의 값을 쓴 실행 결과로 적합했다고 합니다. Batch law를 만들 때 $\alpha_0$를 아무 값으로 고정하면 batch마다 step이 맞지 않아 knee가 엉뚱한 곳에 찍히고, 반대로 batch마다 $\alpha_0$를 다시 탐색하면 실험 비용이 크게 늘어납니다. 그래서 decay law가 주는 값을 그대로 쓴 것으로 보입니다.
실험을 통해 도출한 선험적인 결과
계수는 모두 DEEP 데이터셋 하나에서 로그 공간 OLS 회귀로 얻은 값입니다. 싫머을 통해 거듭제곱, logit, 선형 같은 여러 형태를 비교해서 그 중 가장 나은 결과를 골랐다고 합니다. Knee 기준 0.2%, $n > 2\text{M}$에서의 8배 보정, $\varepsilon$, $\tau$ 같은 값을 직접 정했다고 합니다.
이 식을 도출하기 위해 꽤 많은 실험을 수행한 것으로 보입니다. Decay law에만 62,410번, batch law에 12,219번을 실행했고 다른 데이터셋(SIFT, SPACEV, arXiv, AG-News)에 적용했을 때 regret이 0.07% 수준이었습니다. LLM scaling law로 hyperparameter를 정하는 방법론과 같은 계열이라고 보면 될 것 같습니다. 그래서 지수 값 자체를 외울 필요는 없고 두 법칙이 각각 무엇을 타깃으로 잡았는지, $\alpha_0$와 $B$가 묶여 있다는 점을 기억하면 충분하다고 생각합니다.
한계
법칙에 차원 $d$가 들어 있지 않습니다. $d$의 지수를 넣어 봤지만 추정값이 불안정해서 뺐다고 합니다. 게다가 실제로 중요한 국소 내재 차원(local intrinsic dimensionality)은 보통 알 수 없습니다. 그래서 저차원이거나 작은 데이터셋에서는 최적이 아니라고 논문도 인정합니다. 적합 범위($10^5 \le n \le 10^8$, $256 \le k \le 65{,}536$, $n/k \ge 8$)를 벗어나는 데이터라면 법칙의 값을 출발점으로 두고 주변 값을 몇 개 확인해 보는 편이 안전합니다.
IVF 근사 할당
논문에선 $k$가 수백만 단위로 커질 때를 다룹니다. 이때는 업데이트 규칙은 건들지 않고 할당하는 단계만 바꿉니다. Batch마다 $B \times k$번 거리를 계산하는 것이 병목이 되므로 근사 최근접 이웃 검색(ANNS)을 씁니다.
- Centroid를 meta-centroid $K_{\text{IVF}}$개의 버킷으로 나누고 점마다 가까운 버킷 $L_{\text{IVF}}$개 안의 centroid하고만 비교함
- Centroid가 batch마다 움직이므로 인덱스를 매번 다시 만들어야 함. 그래서 구축이 빠른 IVF를 쓰고 meta-centroid는 처음에 한 번만 학습해 고정함
- 근사 할당 때문에 train MSE는 나빠지지만 test MSE는 거의 그대로임
| 규모 | $k$ | Exact 할당 | IVF 할당 |
|---|---|---|---|
| 1억 | $2^{18}$ | 0.028 GPU 시간 | 0.030 GPU 시간 |
| 10억 | $2^{21}$ | 4.56 GPU 시간 | 1.05 GPU 시간 |
| 100억 | $2^{24}$ | 779 GPU 시간 | 22.8 GPU 시간 |
1억 규모에서는 이득이 없지만 100억 규모에서는 34배 빨라집니다. $k$가 수십만 이하라면 exact 할당으로 충분합니다.
왜 SGD가 아니라 EMA인가
논문의 Appendix에선 EMA 대신 SGD나 Adam으로 centroid를 업데이트해 비교합니다. 작은 batch에서는 비슷하지만 큰 batch로 갈수록 EMA를 제외한 optimizer가 모두 나쁜 성능을 보입니다. 두 업데이트를 같은 형태로 써 보면 이유가 보입니다.
\[c_j' = c_j + f_j (\bar{x}_j - c_j), \qquad f_j^{\text{SGD}} = \frac{2\eta\, n_j}{B}, \qquad f_j^{\text{EMA}} = \frac{\alpha\, n_j}{\gamma N_j + \alpha\, n_j}\]둘 다 batch 평균 쪽으로 비율 $f_j$만큼 이동하는 형태이고 차이는 $f_j$의 범위에 있습니다.
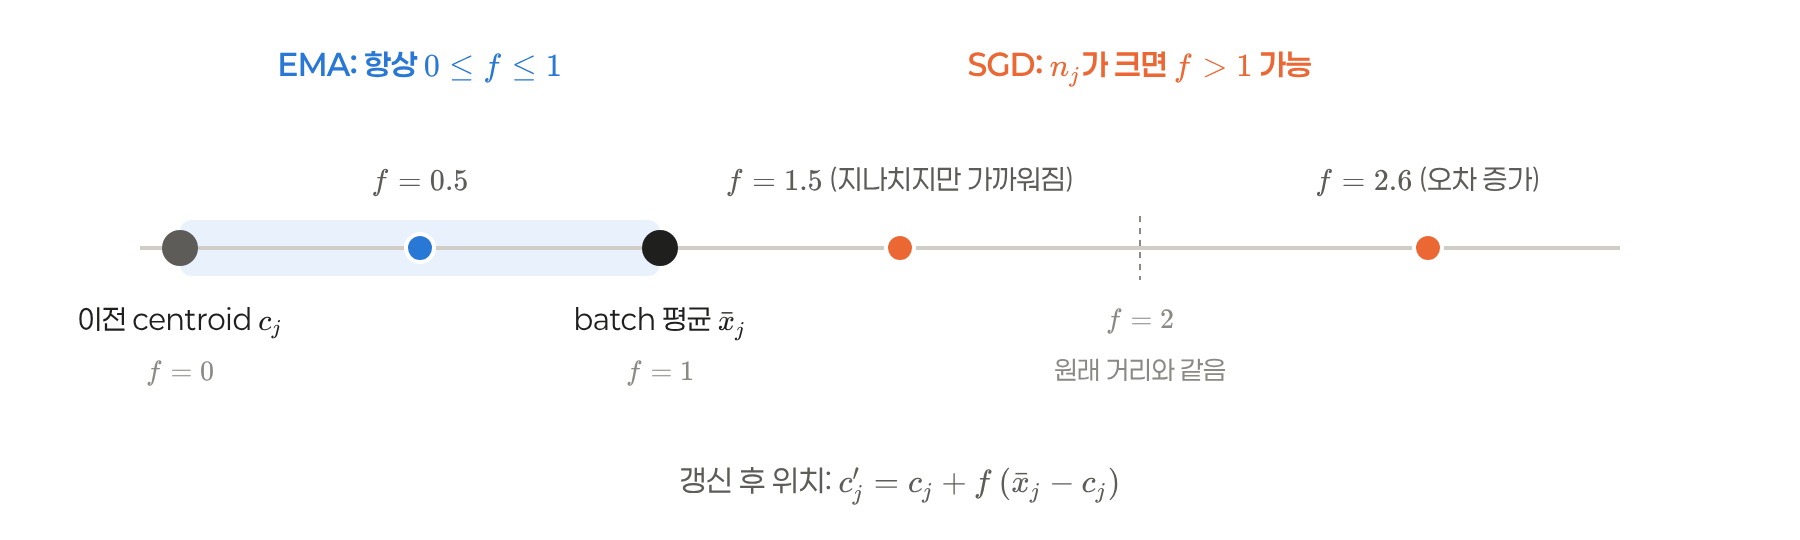 이동 비율 $f$에 따른 업데이트 후 centroid 위치
- EMA: $f_j$가 항상 0과 1 사이라서 centroid가 이전 위치와 batch 평균 사이에 머뭅니다. 논문의 표현으로는 할당된 점들의 convex hull 밖으로 나가지 않습니다.
- SGD: $f_j$가 $n_j$에 비례해서 클러스터마다 다릅니다. 큰 batch에 맞춰 learning rate를 키우면 점을 많이 받은 클러스터는 batch 평균을 지나치고, $f_j > 2$가 되면 오히려 오차가 커집니다.8
EMA가 큰 step을 안정적으로 감당하기 때문에 큰 batch를 쓸 수 있고 큰 batch는 곧 GPU 효율로 이어집니다. 앞에서 본 batch law도 이 전제가 있어야 의미가 있습니다.
마치며
결국 k-means 자체를 바꿨다기보다는 mini-batch k-means를 딥러닝 학습처럼 다룬 논문이라는 인상이 더 큽니다. EMA, 코사인 스케줄, 학습 중 죽은 유닛 되살리기, 실험 기반 scaling law 모두 딥러닝에서는 익숙하게 사용하는 방식입니다. 각 방식을 k-means에 맞게 조합하고 hyperparameter 탐색까지 없앤 결과가 기존 방식인 Lloyd보다 10배 적은 epoch로 이어졌다는 점은 괄목할만 합니다.
직접 써 본다면 아래 정도만 기억하면 될 것 같습니다.
- 고차원 임베딩이고 $n/k \ge 8$이면 스케일링 법칙의 $B$와 $\alpha_0$를 그대로 씀
- Revival은 끄지 않음
- Centroid를 학습 데이터에 쓰면 last-epoch-mean, 새 벡터에 쓰면 slow EMA
- 초기화는 무작위로 충분함
- $k$가 백만 단위를 넘으면 IVF 근사 할당을 검토함
학습 중에 centroid가 계속 움직이므로 과거에 할당된 결과는 지금과 다른 위치의 centroid를 기준으로 이루어진 결과입니다. 그래서 이를 잊는 편이 현재 위치에 맞는 평균에 더 가깝다고 생각합니다. running mean은 학습 초반의 잘못된 할당도 끝까지 같은 가중치로 남깁니다. ↩︎
이 효과는 Adam이 초기 moment를 $1 - \beta^t$로 나누는 bias correction과 비슷한 역할로 볼 수 있습니다. 또 클러스터가 처음 점을 받을 때는 $\alpha$와 무관하게 이동 비율이 거의 1이므로, 코사인 스케줄을 warmup 없이 peak에서 바로 시작해도 초반이 불안정해지지 않는 이유로 볼 수도 있습니다. 논문은 $N_j$ 초기값을 따로 ablation하지 않았습니다. ↩︎
상대 기준을 쓰는 이유는 논문에 나와 있지 않습니다. Faiss의
split_clusters는 할당 수가 정확히 0인 클러스터만 대상으로 iteration마다 실행합니다. Pertubation 크기는 FP16 epsilon보다 조금 큰 1/1024를 씁니다. e-means의 $2^{-7}$은 이보다 8배 큽니다. ↩︎이유를 크게 세 가지 정도로 생각해봤습니다. 첫째로 점이 많은 클러스터를 나눌수록 같은 centroid 하나로 손실이 더 많이 줄어듭니다. 그리고 작은 클러스터를 나누면 두 자식의 count가 모두 임계값 아래로 떨어져 다음 검사에서 곧바로 다시 dead가 됩니다. 마지막으로 큰 클러스터부터 나누면 클러스터 크기가 고르게 됩니다. 실제로 donor 분할을 쓸 때 클러스터 크기의 불균형 지표가 가장 낮았습니다. ↩︎
예를 들어 어떤 클러스터가 마지막 epoch에 점 100개를 batch마다 하나씩 받고 끝 무렵 $\alpha$가 0.05라면, EMA centroid는 사실상 최근 20~40개 점에 치우친 평균입니다. 클러스터당 점이 적을수록 이 표본 잡음이 커지므로 $n/k$가 작을 때 효과가 큰 것도 같은 이유로 설명됩니다. 수치는 설명을 위해 가정한 값입니다. ↩︎
새 벡터에 쓰는 경우의 예로는 IVF의 coarse quantizer나 PQ codebook을 들 수 있습니다. ↩︎
$B^{0.90} k^{-0.46}$은 batch 하나에서 클러스터 하나가 받는 점의 수 $B/k$와 방향이 같습니다. 점을 많이 받을수록 batch 평균을 더 믿고 크게 움직여도 된다고 읽을 수 있습니다. 또 batch law를 대입하면 epoch당 업데이트 횟수가 $n/B \propto n^{0.12}$라서 $n$이 커져도 거의 일정합니다. ↩︎
큰 batch에서 SGD가 망가지는 이유는 논문에서 따로 설명하진 않습니다. 논문에선 convex hull 논증을 가설로 제시하고 EMA의 learning rate를 $\eta = (1-\gamma)/2$로 환산해 비교합니다. 손실을 클러스터별 평균으로 두면 $f^{\text{SGD}} = 2\eta$이고 정상 상태의 EMA는 $f^{\text{EMA}} \approx \alpha$이므로 이 환산식이 나옵니다. ↩︎